

返回
技术文章
AI Coding Agent 的安全问题已经进了供应链
说明 Coding Agent 会读取并执行 Skill、MCP、依赖和仓库指令,因此这些组件应按软件供应链治理,而不只是做 Prompt 安全。
AI Coding Agent 的安全问题已经进了供应链#
9 月 8 日,Google Threat Intelligence Group 发布了新的 AI Threat Tracker。 报告里最值得 Builder 注意的,不是某个模型又能做什么攻击,而是攻击者开始把 Agent 当成执行系统使用。 GTIG 记录到一场 2026 年第二季度的行动。攻击者先攻破云资源,然后完成攻击规划、基础设施搭建和大规模凭据收集。整个过程不到 6 小时。 报告还提到另一个更贴近开发者的问题。UNC6780 在开源软件供应链攻击中,会利用 AI coding assistant 和 LLM 安全扫描工具接触依赖、仓库内容和构建环境的路径。 这意味着 Agent 安全不能只看 Prompt。
Agent 会信任什么#
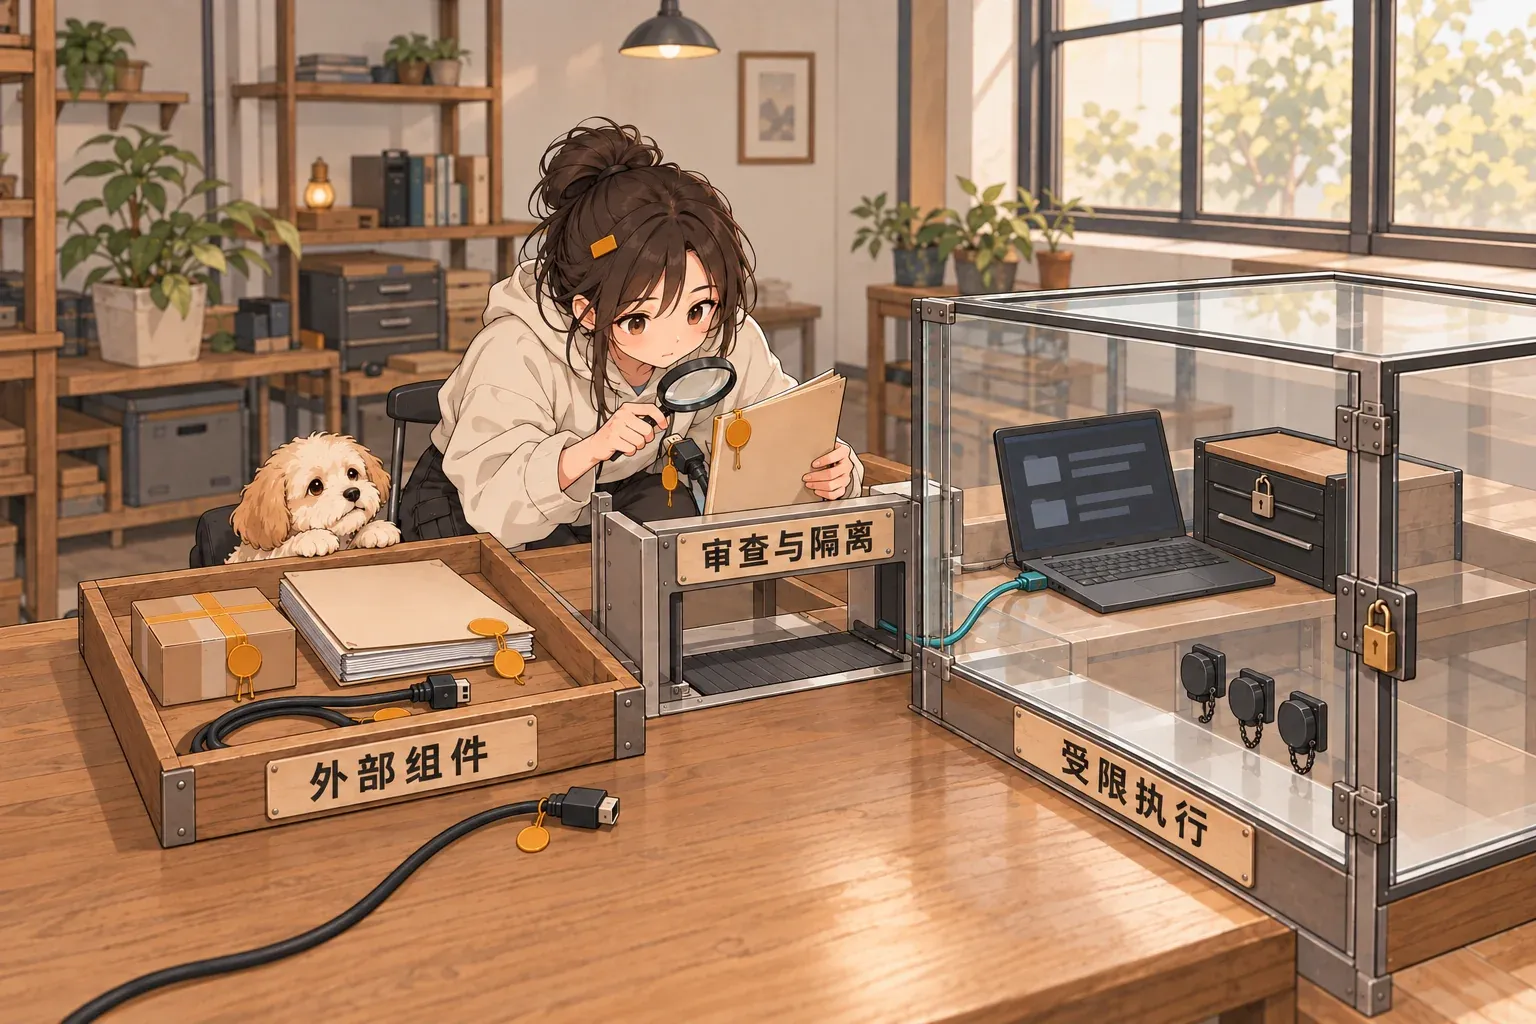
传统软件供应链主要检查代码、包、镜像和构建脚本。 AI coding agent 又增加了一批输入。 它会读取 AGENTS.md ↗、CLAUDE.md ↗、Skill 文件、MCP 配置、仓库文档、依赖清单和工具返回结果。很多 Agent 还能直接执行 Shell、修改文件、调用云服务或操作外部系统。 这些输入有一个共同点。它们可以改变 Agent 下一步做什么。 如果一个恶意依赖能让程序执行错误代码,它属于供应链风险。如果一个恶意 Skill 或仓库指令能让 Agent 调用错误工具、读取不该读取的文件或把凭据发到外部,它同样属于供应链风险。 区别只在执行路径。
Google 看到的攻击已经碰到 AI 开发链#
GTIG 的报告明确写到,攻击者正在针对开发者、AI coding assistant 和 LLM security scanner。 这类攻击不要求突破模型本身。 攻击者可以污染 Agent 会读取的开源依赖、项目文件或工具链。Agent 如果把这些内容当成可信输入,再配合较高权限,就可能把传统供应链问题放大。 Google 在此前的开发者安全研究中也把 AI coding agent 的攻击面拆成四类:会执行的文件、会指导 Agent 的文件、负责连接工具的配置、负责扩展能力的组件。 这个分类很实用。因为它直接对应 Builder 日常会接触的项目文件。
Skill 和 MCP 为什么要进入安全审查#
9 月 3 日,Tenable 宣布 CyberAgents Exchange AI Inspector。 它的检查对象没有停在 Agent 本身。官方列出的对象包括 Agent、Skill、MCP Server 和多 Agent Playbook。 这很接近软件包扫描器的思路。 你从社区安装一个 Skill,本质上是在给 Agent 增加一套长期指令。你连接一个 MCP Server,本质上是在增加一组可调用能力和外部数据源。你引入一个 Playbook,本质上是在引入一条新的执行路径。 这些东西都需要知道来源、版本、权限和行为范围。 “能装”不是安全判断。
权限边界会越来越重要#
同一天,Zayo 发布了面向网络操作的 Agentic Networking,并提供生产 MCP Server。 官方明确写到,获批 Agent 可以读取网络上下文,并执行授权的网络变更。 当 MCP 能控制网络、云资源、数据库或生产系统时,安全问题就很具体了。 一个 Tool 能不能调用,调用时用谁的身份,能操作哪些资源,失败后怎么回滚,每次调用有没有审计记录,这些都应该由执行层控制。 Prompt 可以告诉 Agent“不要做危险操作”。真正的权限边界应该让危险操作在没有授权时无法发生。
Builder 现在可以做什么#
第一,固定来源和版本。 不要让生产 Agent 自动拉取未知 Skill、MCP Server 或依赖的 latest 版本。记录来源仓库、版本和哈希。升级走明确流程。 第二,缩小工具权限。 每个 Tool 只拿完成任务需要的权限。读和写分开。涉及外发、删除、付款、部署和网络变更的操作单独审批。 第三,隔离执行环境。 能运行 Shell 或代码的 Agent 放进沙箱。限制文件系统、网络和 Secret 的可见范围。不要让一个开发 Agent 默认拿到整台机器的权限。 第四,记录信任链。 日志里不要只记模型输出。还要记它加载了哪个 Skill,连接了哪个 MCP Server,读了哪些外部指令,调用了什么工具,使用了什么身份。 第五,把外部组件放进 Eval。 升级 Skill、MCP Server 或依赖后,重新跑关键任务和安全测试。检查权限越界、外发、异常工具调用和结果变化。
最后一个判断#
Agent 的风险不只来自模型回答错误。 Agent 会执行,所以它信任的组件也需要被审计。 以后做 Agent 安全,我会把 Skill、MCP、依赖和仓库指令统一放进“可执行信任链”里管理。这个边界比单独讨论 Prompt Injection 更接近真实产品。#

阅读完成 · 回笔记列表
评论
评论公开保存在 GitHub Discussions。
正在准备评论区…
评论框就绪后可以使用 GitHub 登录参与讨论,也可以直接打开仓库 Discussions。 打开 GitHub Discussions ↗评论会发布到 lora-sys/loraSys 仓库的公开 Discussions。