把 AI Agent 拆成三层,Tau 架构解决了什么
以 Tau 为例,说明模型适配、Agent 核心和应用层的职责,以及工具和前端如何在不互相依赖的情况下协作。
给编程 Agent 更换模型或增加网页界面时,最容易遇到的问题是代码之间的依赖。核心循环直接输出终端文字,工具读取界面状态,前端解析模型供应商的原始响应。改一处功能,往往要同时修改几个模块。
Tau 把模型适配、Agent 核心和应用拆开。应用使用核心,核心使用模型适配层,核心不反向依赖界面。这样,更换界面时就能保留已有的消息和工具处理逻辑。[1]
三层分别负责什么#
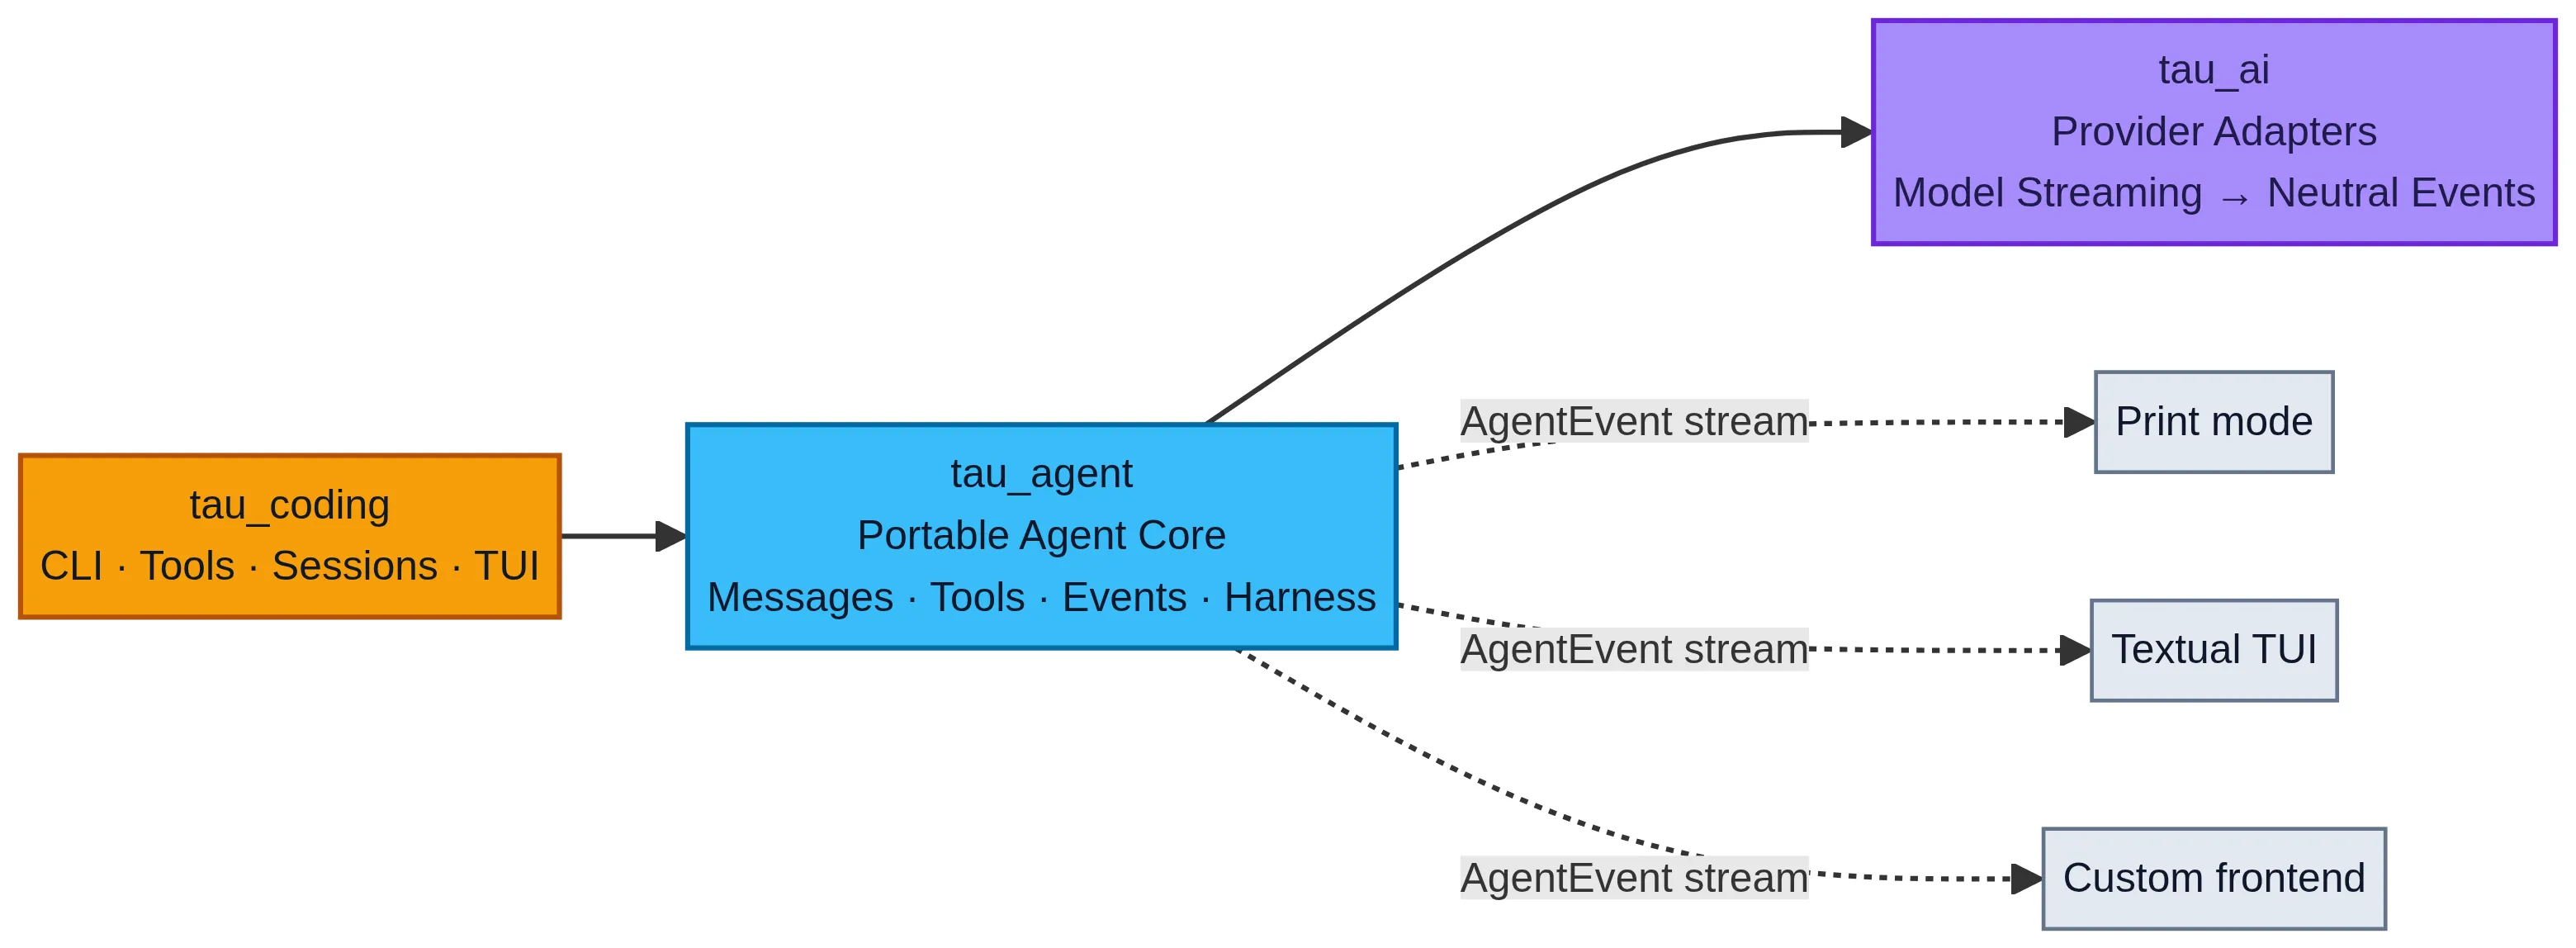
Tau 三层架构示意图。
切换查看三层职责
- 调用模型供应商并把流式响应转换成统一事件
- 不依赖具体界面和编程工作流
- 组织消息、工具、事件、循环控制和会话基础能力
- 不依赖命令行界面、Textual、Rich 或应用资源加载
- 提供编程助手的命令行、工具、项目说明、技能、磁盘会话和终端界面
- 消费核心事件,不继续向界面暴露供应商原始协议
依据 Tau 架构说明与设计原则 [1][3]
依赖顺序是 tau_coding 使用 tau_agent,tau_agent 使用 tau_ai。终端界面和网页界面都可以消费核心发出的事件。[1]
tau_ai 处理模型供应商之间的格式差异。例如,供应商对文本增量、工具调用和结束状态可能采用不同结构。适配层把这些差异转换成共同的事件结构,上层就不必分别解析每家供应商的响应。
tau_agent 处理一次运行中的状态变化。它准备上下文、接收模型请求、执行工具并记录结果。它不需要知道用户点击了哪个按钮,也不负责决定磁盘会话应放在哪个应用目录。
tau_coding 把这些能力组合成编程助手。项目说明如何加载,工具如何配置,会话如何保存在磁盘,用户如何取消运行,这些具体应用行为由这一层组织。[1][3]
核心发事件,界面负责显示#
假设 Agent 需要读取文件,然后向用户展示检查结果。核心可以发出消息更新、工具开始和工具完成事件。终端收到事件后打印文字,网页收到事件后更新组件。
反过来,如果核心直接调用终端组件,网页端就无法单独复用它。测试也必须创建界面,才能验证原本只涉及消息和工具的逻辑。
下面是教学伪代码,不是 Tau 源码。它只说明如何把事件产生与渲染分开,不是完整 Agent Loop。
from typing import AsyncIterator, Protocol


class ModelEvents(Protocol):
    def stream(self, messages: list[dict]) -> AsyncIterator[dict]: ...


class AgentCore:
    def __init__(self, model: ModelEvents, tools: dict):
        self.model = model
        self.tools = tools

    async def run_turn(self, messages: list[dict]):
        async for event in self.model.stream(messages):
            yield event
            if event["type"] == "tool_call":
                result = await self.tools[event["name"]](**event["args"])
                messages.append({"role": "tool", "content": result})


async def render_terminal(events):
    async for event in events:
print(event)这个示例没有在工具完成后再次请求模型,也没有完整保存助手工具调用消息及其标识。它还省略了参数校验、异常处理、取消和循环次数限制。实际应用不能直接把这段代码作为完整运行器。
这里要观察的是依赖位置。print 在渲染函数中,不在 AgentCore 中。增加网页界面时,可以新增一个事件消费者,而不是把显示逻辑写入核心。
哪些写法会破坏分层#
核心直接输出终端内容#
核心中出现终端渲染,会给网页、测试和批处理带来不需要的输出。核心应该报告发生了什么,由消费者决定如何显示。[2]
工具读取界面的临时状态#
文件编辑工具如果直接读取某个界面的当前选中行,就无法在其他入口中复用。应用应先把选中内容转换成明确的工具参数。
Tau 将工具组织为带名称、描述、输入结构和异步执行器的类型化函数。界面状态不应成为工具隐藏的输入。[3]
前端解析供应商原始分片#
前端直接解析某一家供应商的响应后,供应商协议就会影响界面代码。增加第二家供应商时,往往需要再写一套分支。把转换放在模型适配层,前端就能继续处理统一事件。[1][2]
为没有发生的需求增加层级#
分层应该对应独立职责。模型适配、循环控制和界面会因不同需求而变化,所以值得分开。没有独立职责的目录,不必为了形式再拆一层。
一个代码审查 Agent 的分工#
考虑一个具体需求。用户提交 Git diff,Agent 读取相关文件、执行检查,再把发现展示在终端。后续还需要网页入口。
模型适配层负责模型调用与响应转换。Agent 核心负责消息、工具请求和运行事件。审查应用提供读取 diff 的工具、项目规则和会话存储。终端与网页分别显示同一套运行事件。
这样,读取 diff 的工具不需要知道当前使用的是网页还是终端。网页也不需要解析供应商的工具调用分片。
下面几个操作可以用来检查分工是否清楚。
| 操作 | 合适的位置 |
|---|---|
| 将供应商的工具调用分片转换为统一事件。 | 模型适配层。 |
| 将工具结果写回对话记录,继续请求模型。 | Agent 核心。 |
| 响应取消按键,调用会话的取消接口。 | 应用或前端层。 |
| 把运行进度显示为终端进度条。 | 前端层。 |
在自己的项目中检查一次#
打开核心循环所在文件,检查它是否导入了网页或终端界面组件,是否直接读取应用特定目录,是否直接打印供应商的原始分片。
可以先把一处渲染改成发出事件,再写两个消费者。一个把事件收集成列表,另一个打印事件。
async def collect_events(events):
    return [event async for event in events]


async def print_events(events):
    async for event in events:
print(event)测试时,应分别给两个消费者提供新的事件流,不能让它们先后读取同一个已经耗尽的生成器。
两个消费者不依赖核心内部实现,说明这一处显示逻辑已经可以独立替换。接下来再检查工具输入和供应商协议,不需要一次重写整个项目。
参考资料#
[1] Tau 架构说明 ↗。
[3] Tau 设计原则 ↗。